agent 开发实践
从一次修改待办提醒的对话出发,讲清 ART 到 Agent 工具调用的演变、会话压缩、多轮评测,以及如何用 RSI 持续改进提示词。
从一次修改待办提醒的对话出发,讲清 ART 到 Agent 工具调用的演变、会话压缩、多轮评测,以及如何用 RSI 持续改进提示词。
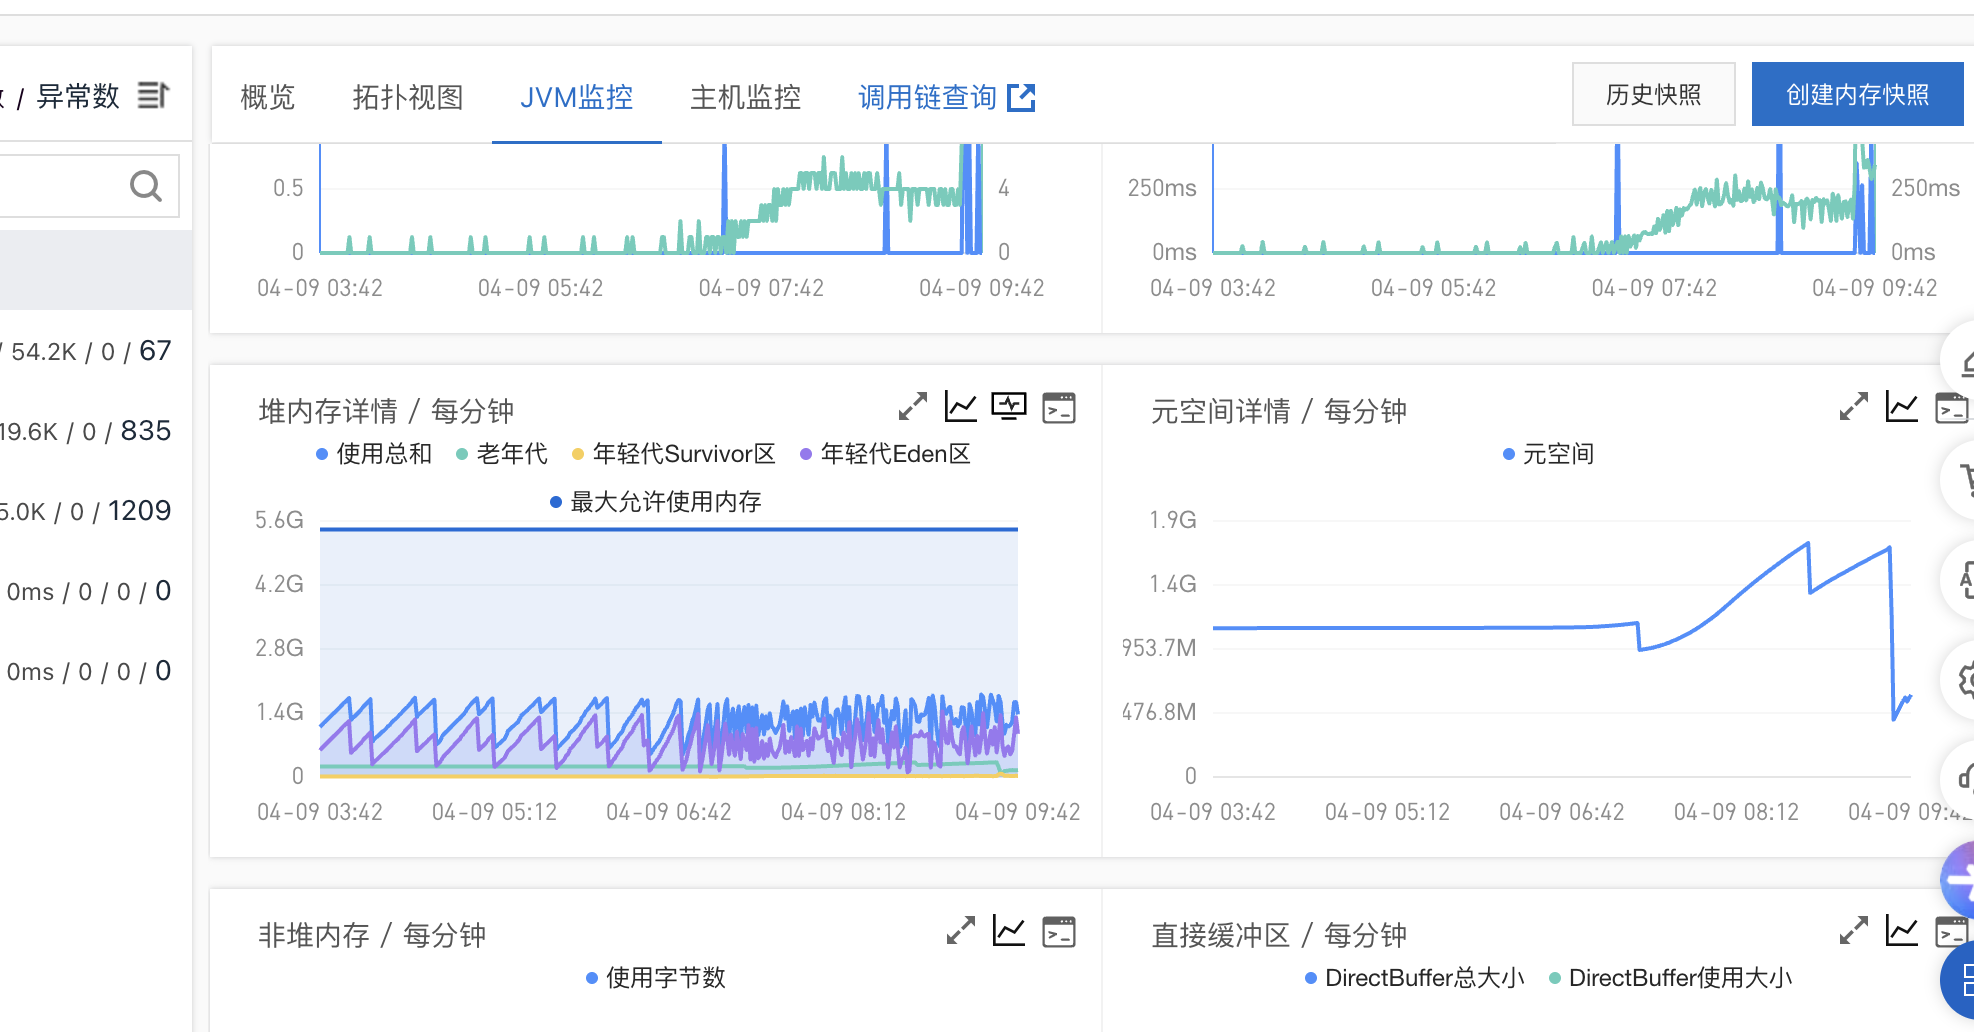
小伙伴反馈服务越来越卡,查看arms监控发现,服务jvm元空间一直在涨,正常情况下,这个应该是不动的,或者微弱波动。

1 |
|
1 |
|
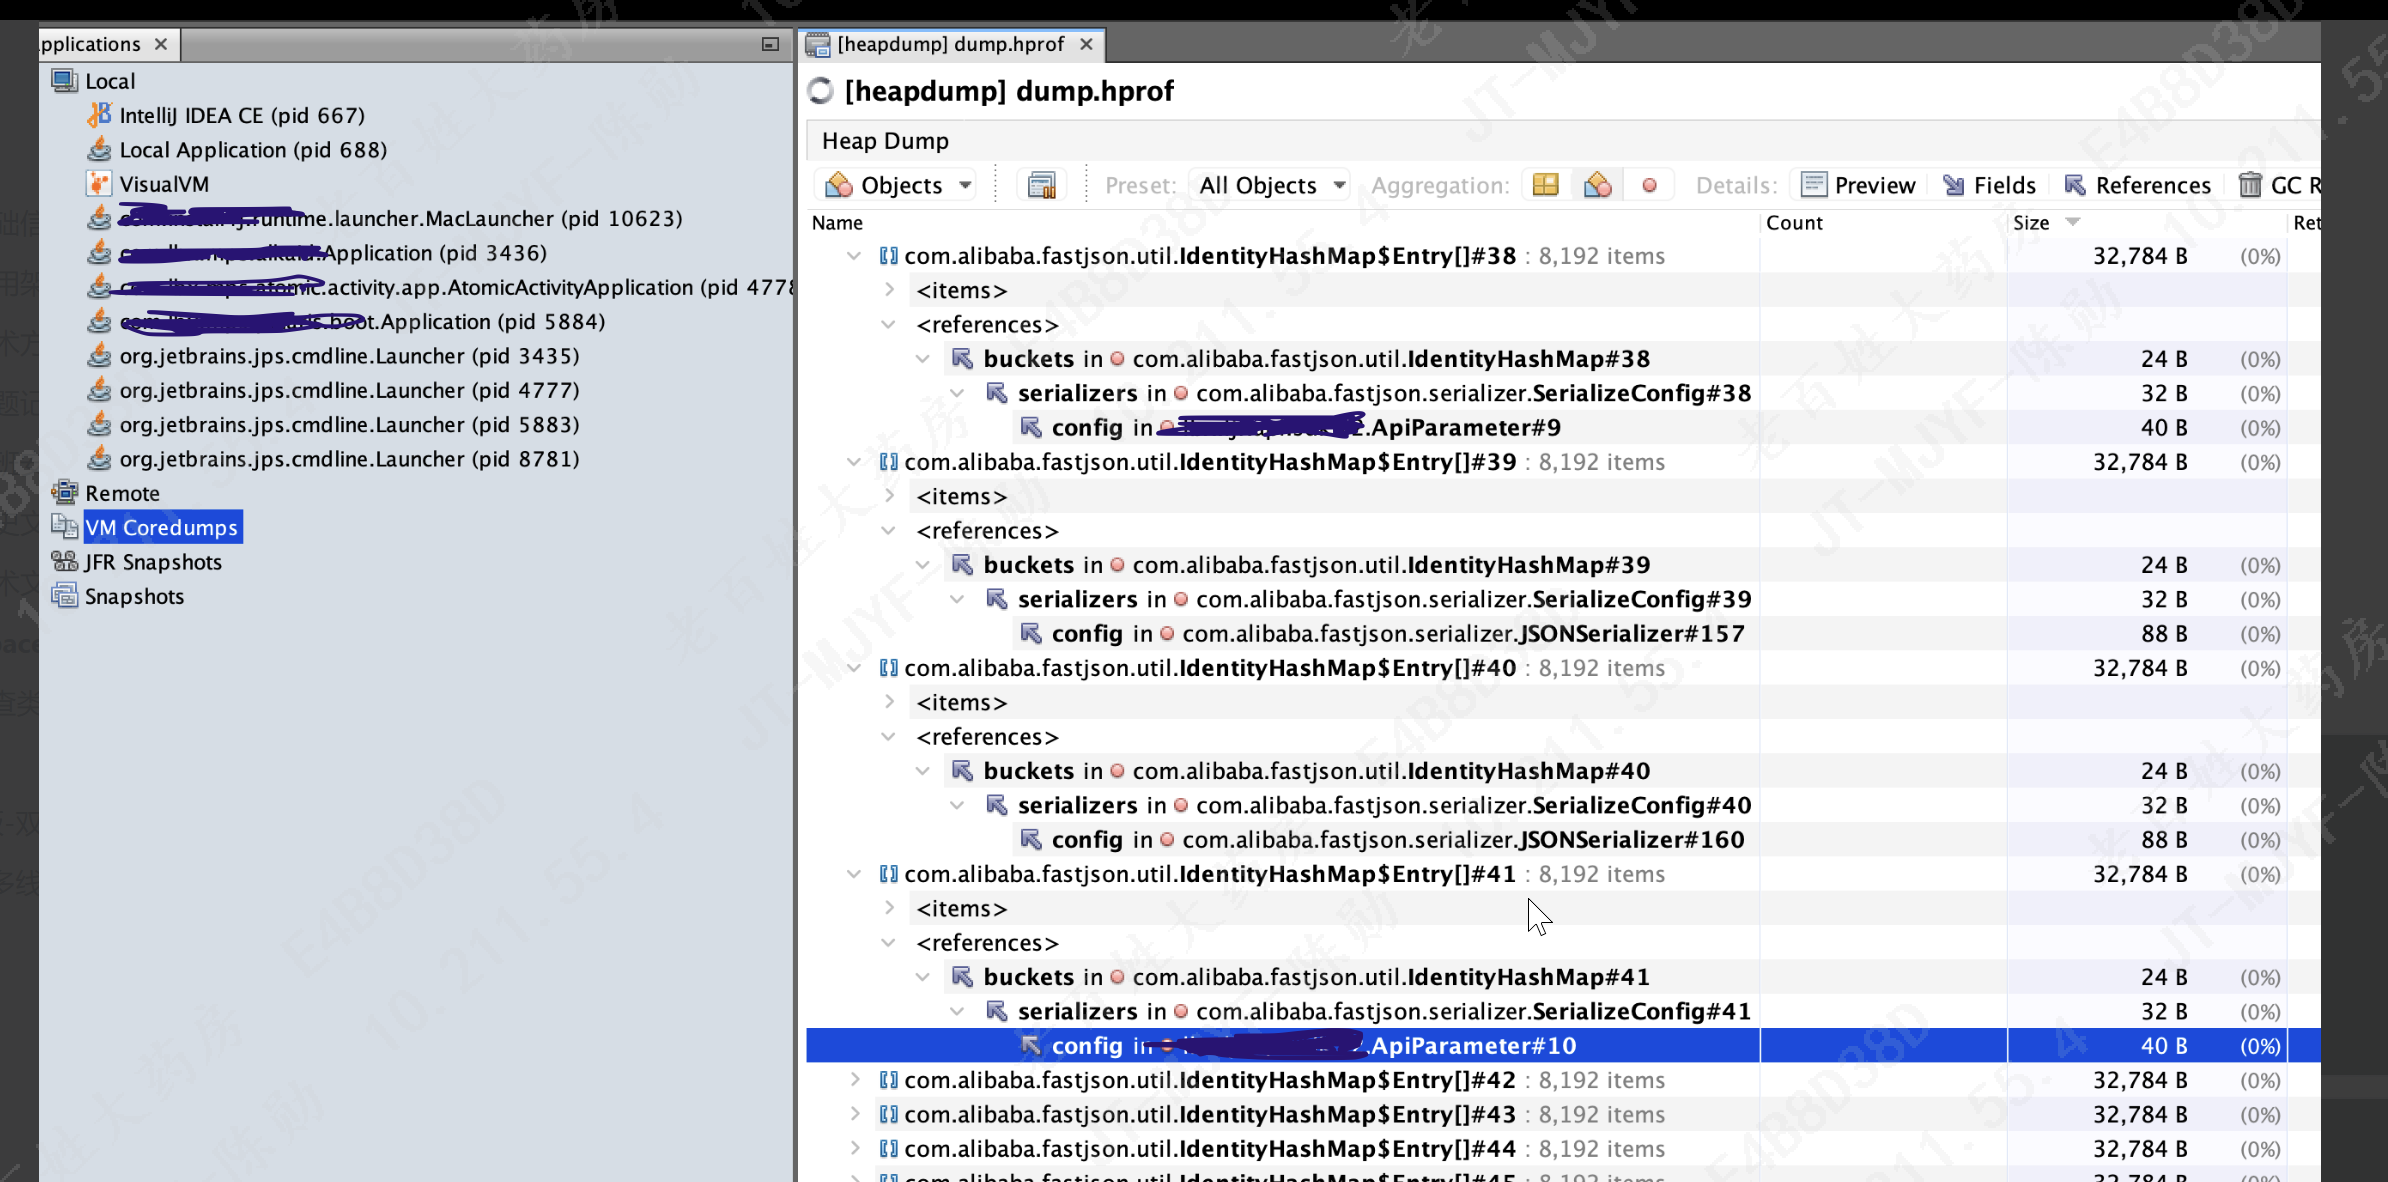
WebApiSdkUtil类,执行postJsonEx方法,会生成ApiParameter对象,这个对象会 new SerializeConfig对象,导致元空间一直涨,
一直到classloader卸载才能回收
发现问题,到定位原因,以及修复花了些许时间,在Ai时代,此类问题是否在Ai的支持下,能否做到自动发现,自动修复,耗时缩短到几分钟呢。
记录最近踩的jenkins大坑,知识点比较零散
最近计划通过测试覆盖率工具来量化测试工作,避免漏测,少测试,因此选型jenkins+jacoco来实现
百度和谷歌了一把,都没找到有效的,这里吐槽一下百度,大量重复的内容
参考了一番搜索结果,查了下jenkins官网资料,最终有效的办法是注释掉报错的xml节点
xml文件路径在 配置的{jenkins_home}目录下
根本原因是 新旧版本xml格式不兼容
jenkins 所有配置都使用xml方式存储的,遇到坏掉的插件,可以直接注释,或者修改成对应版本的格式
job配置的xml在{jenkins_home}/jobs/{job_name}/config.xml
只要xml没被删除,可以通过xml还原之前的配置
这个问题如果使用maven项目则比较麻烦(jenkins哪些版本没这个bug,具体不详),改成使用pipeline构建job
理论上来说,编译使用的jdk版本和jenkins进程使用的jdk版本完全是隔离,例如 jenkins 使用11,项目使用8,反之亦然
推断原因应该是jenkins的maven项目 使用 scriptEngine 执行shell的时候,写法有问题。
基础的 jenkins pipeline我不介绍了,搜索一下,或者自己看官网文档。下面列下进阶技巧
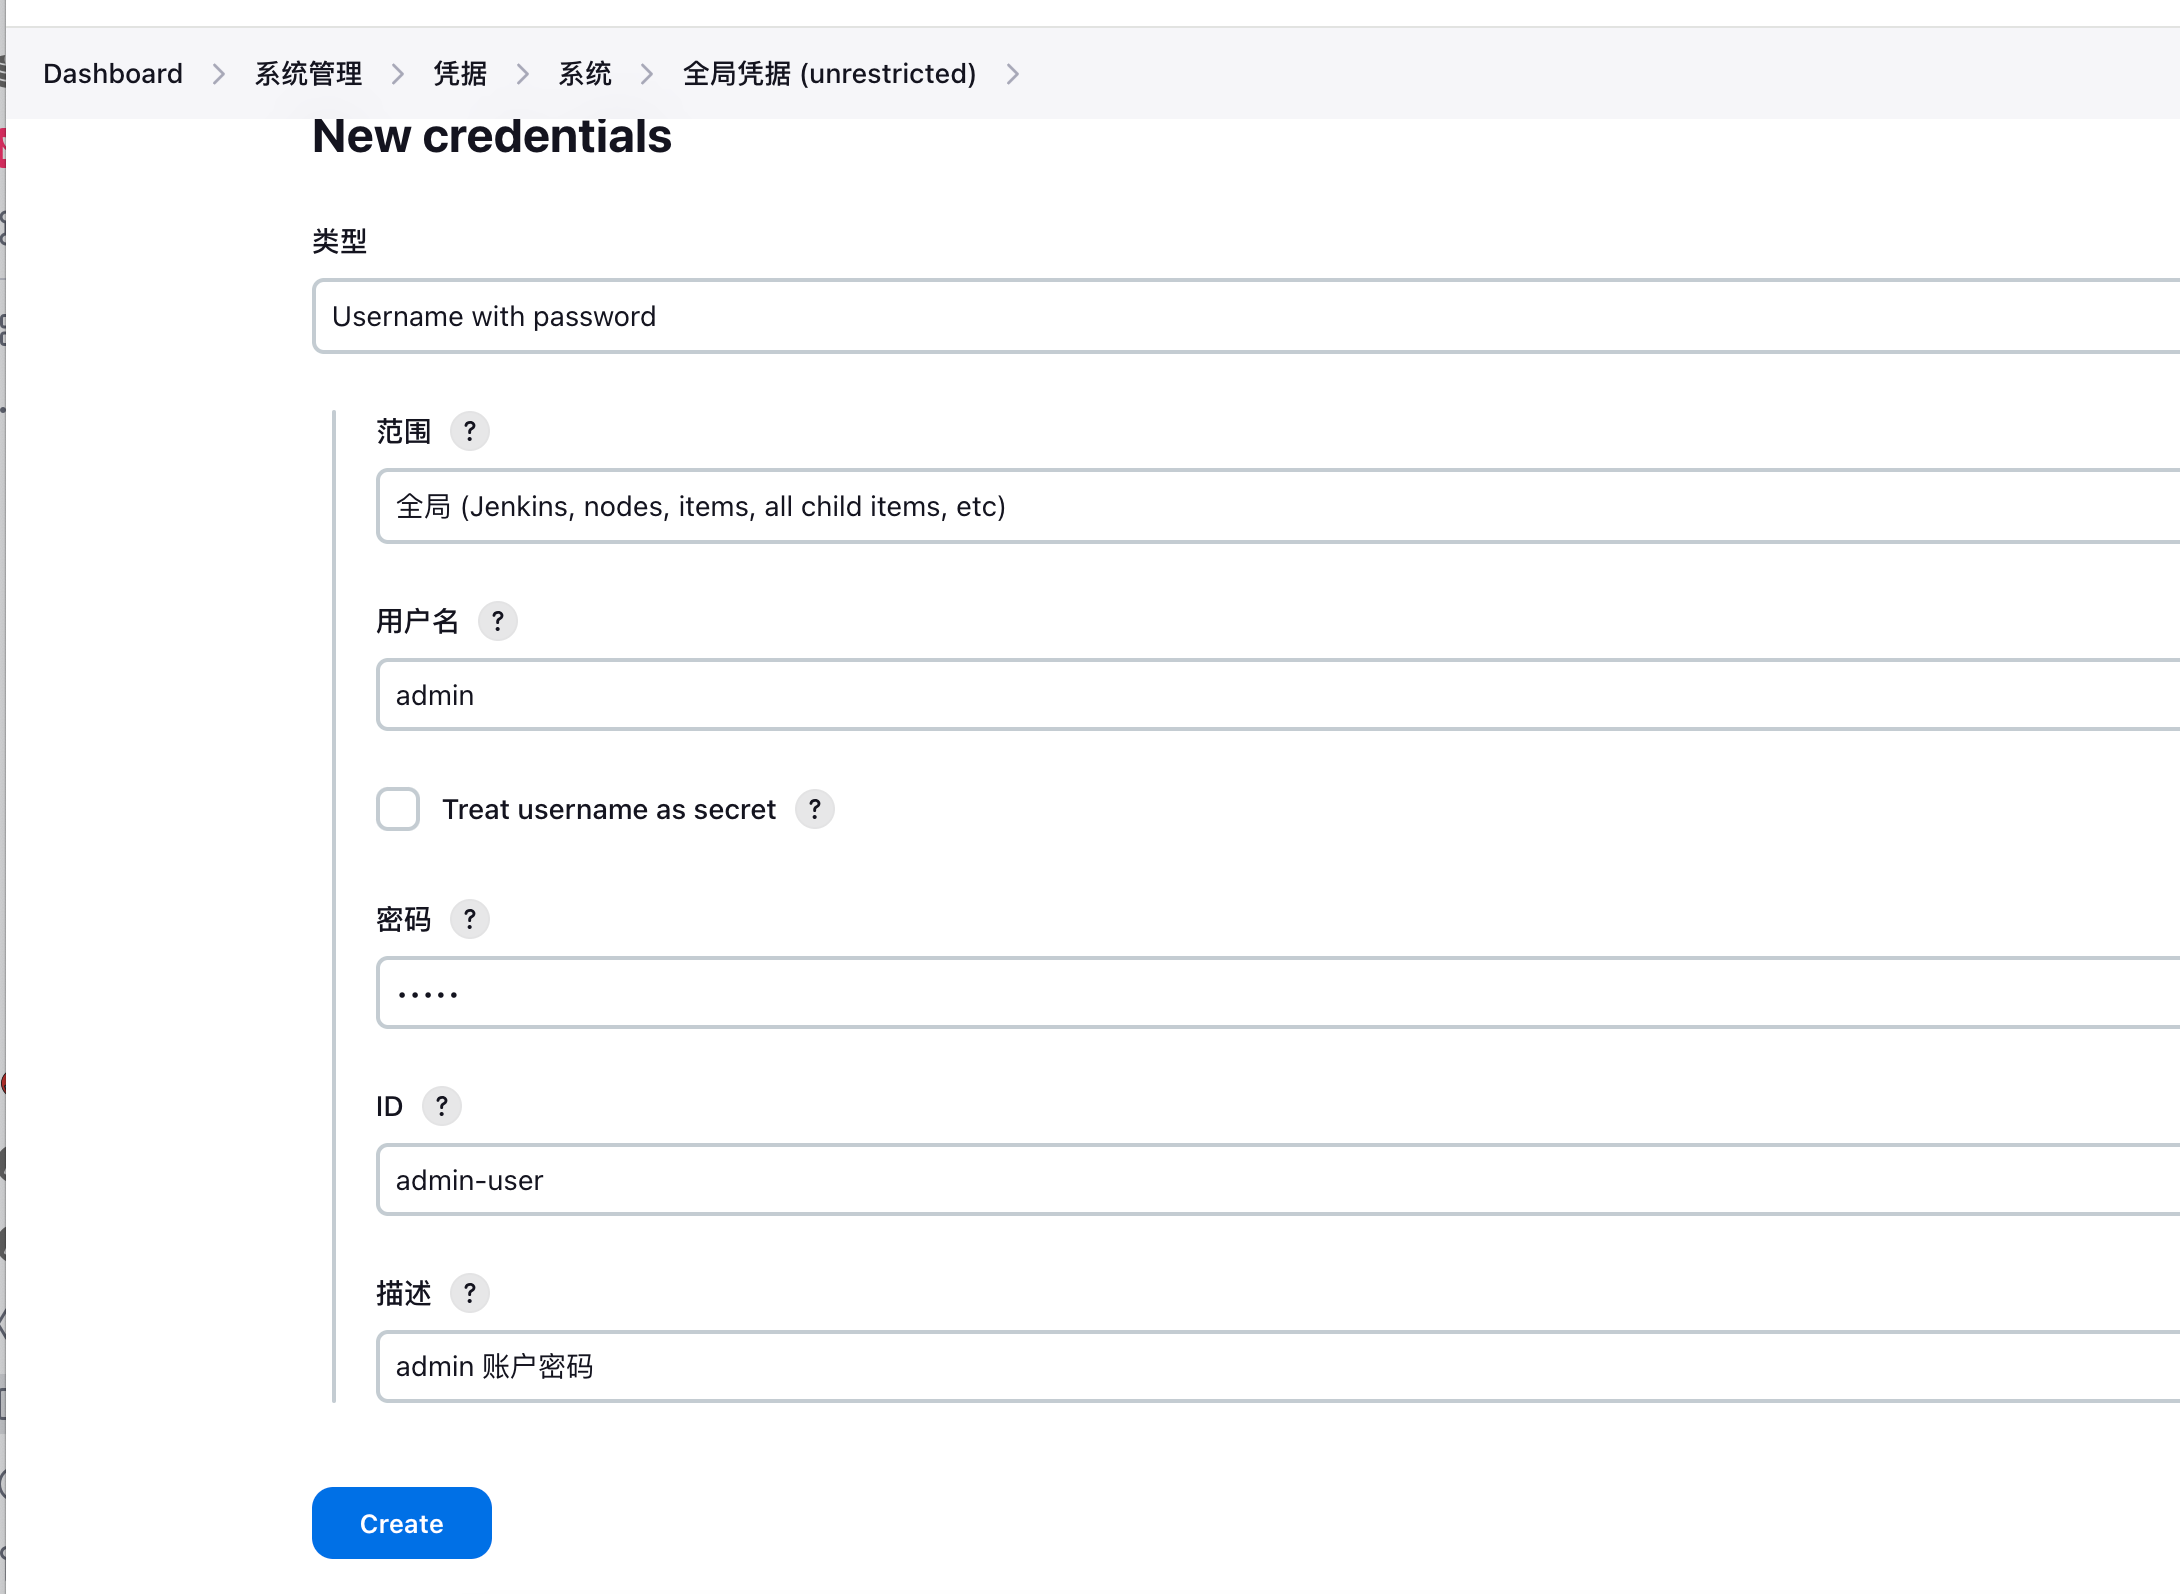
jenkins job 有时候会涉及访问远程资源就需要使用对应的账户,例如git账户,oss账户,或者服务器账户
安全上来讲要统一使用凭证管理
1 | pipeline{ |
打印出来的用户名/密码是星号
大部分时候jenkins所在的服务器和java服务运行的服务器不是同一个,这个时候就需要上传jar到远程服务,且运行启动脚本
网上查了下资料,大部分使用publish over ssh,但这个插件已经不维护了,最新版本jenkins插件市场都找不到
推荐的替代方案是使用 SSH Pipeline Steps 替代
1 |
|
当前workspace 在{jenkins_home}/workspace/{job_name}
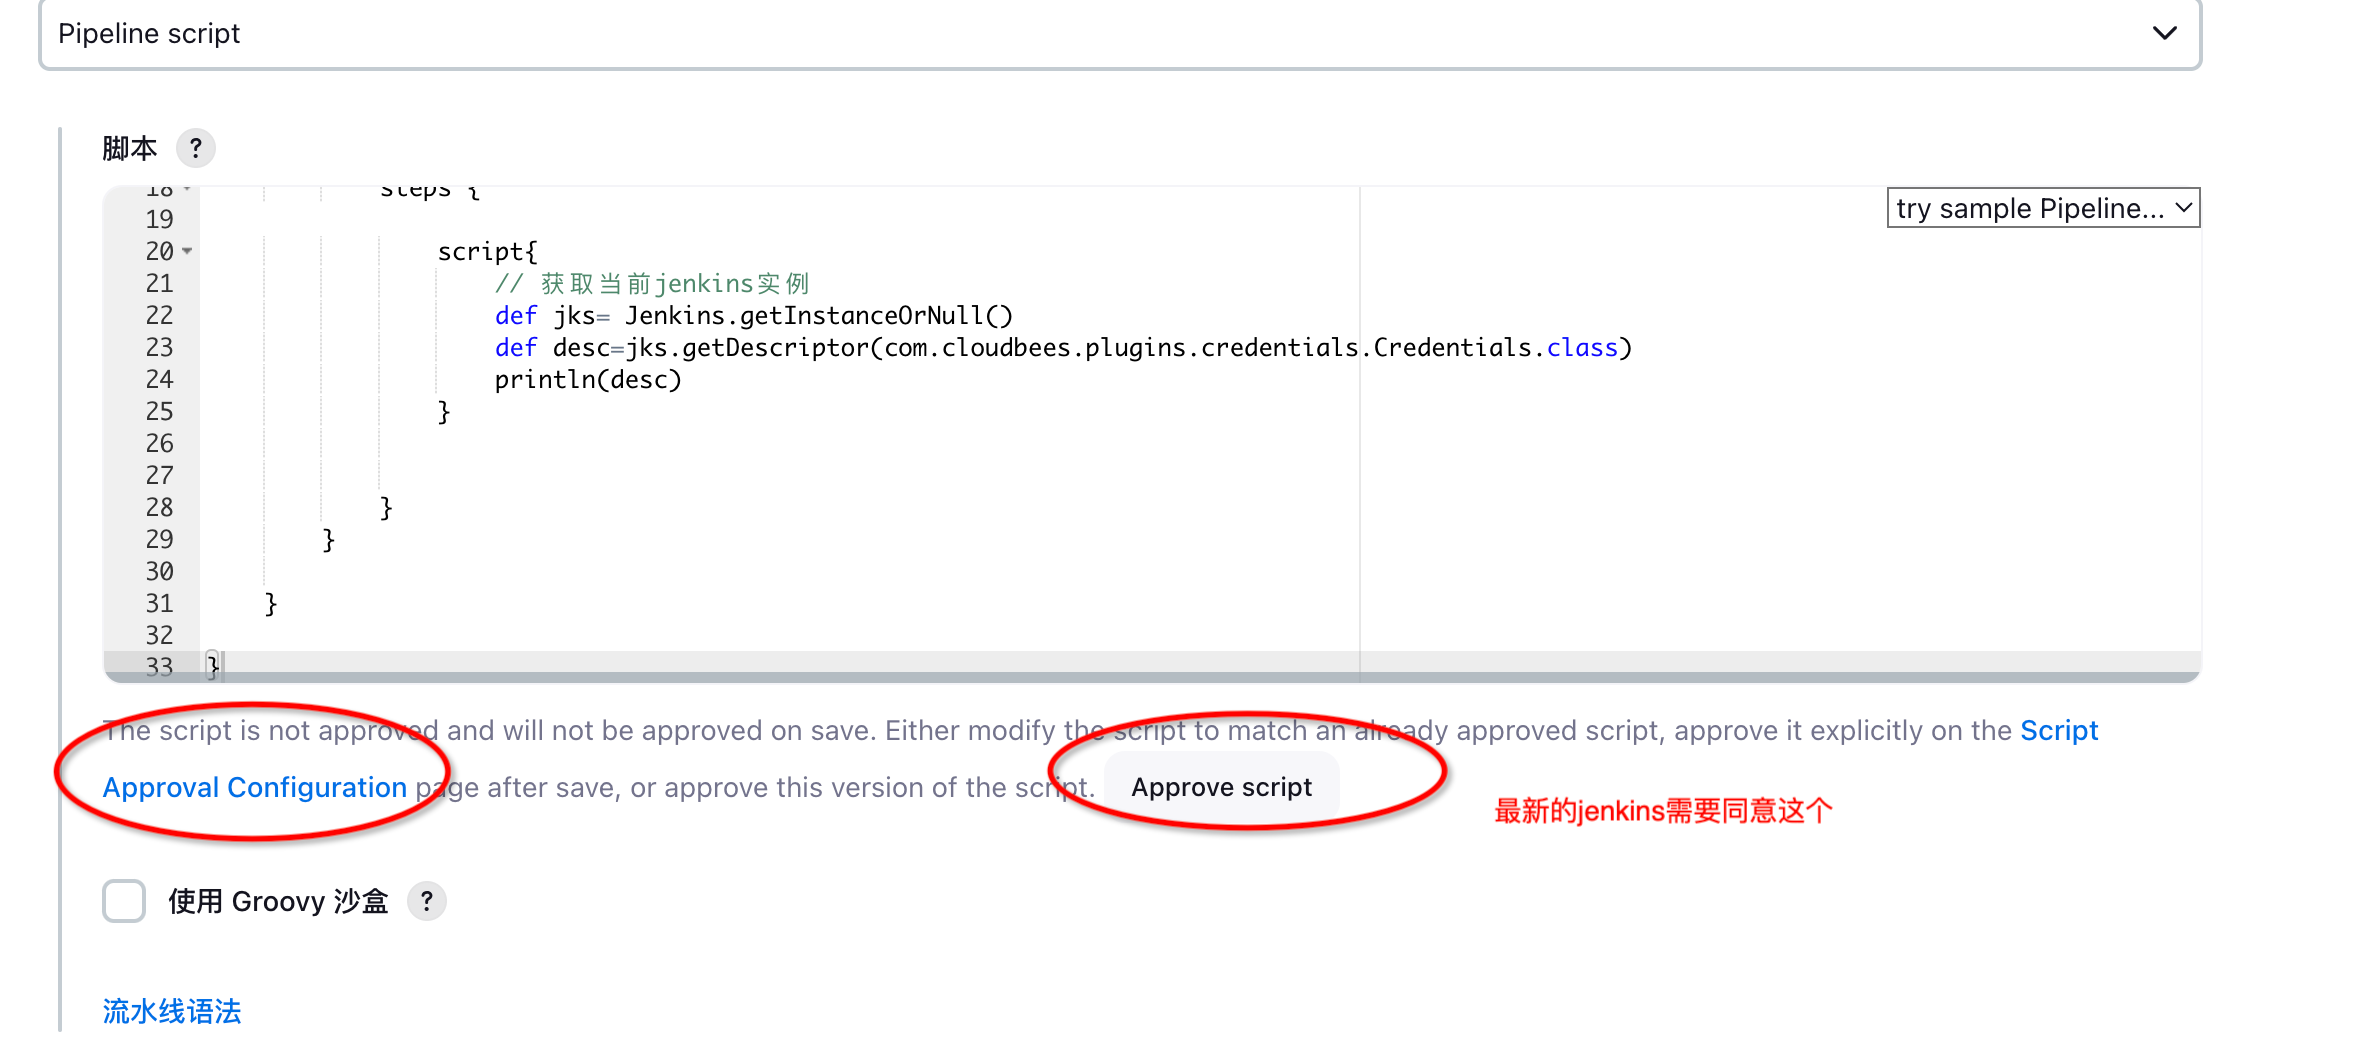
有时候有些疑难杂症,难以解决,需要在脚本运行期间使用 jenkins进程相关信息
注意,不要勾选沙箱运行,因为要获取jenkins实例,要突破沙箱限制
1 |
|
高版本的jenkins除了关闭沙箱之外,还需要授权同意
1 |
|
主体,哲学上讲事物的主要部分,本地生活场景下营销主体,主要指用户围绕什么下单。
业务软件架构绝大部分都是基于业务模型来建设,最终业务模型反映到存储模型上。
举个具体例子,假设某个平台,有100w商户,每个商户有100个商品,每个商品可独立配置优惠,也可能是组合优惠。
可预计的优惠规则是个庞大的数量,主体的选择对性能影响是非常大。
例如 一个商品原价10元,特价2元,配送费1元,有一个满20减5元的活动,假设满减的门槛是按照商品原价,
用户购买2件商品,则实际支付是1元还是0元,则取决于满件的优惠主体是什么,是否能作用于配送费,这个目前没有标准答案,选择不同,结果不同。
实际过程中,没有标准的答案(有优点就一定有缺点),要看业务发展阶段,技术架构是随着业务发展一起演变
会员用户A 在商店B 里面购买商品满30 减10元。我们用这个简单场景来展开讲讲营销名词。
营销包含的基础名词,有主体(围绕什么做营销),对象(营销的目标),形式(具体的规则)
广义上有价值的都能做营销主体,在本地生活电商领域一般有
营销对象是对用户进行分层,不同用户使用的营销策略不一样。在本地生活电商领域一般有
营销形式一般包含以下几种
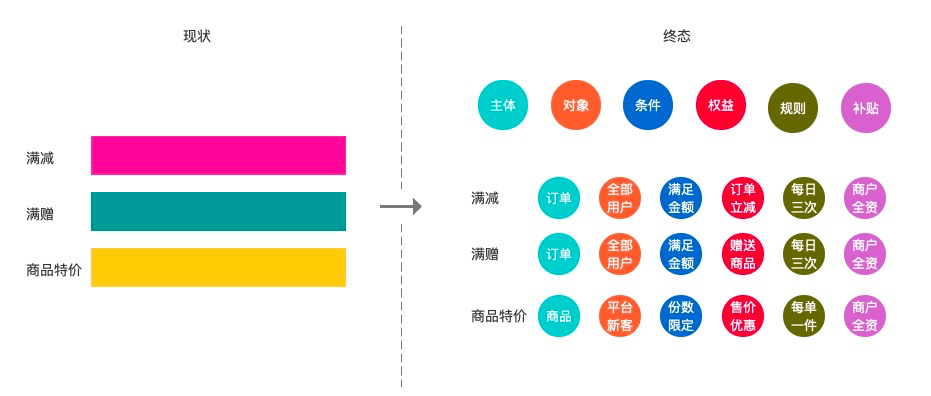
回到最开始的 会员用户A 在商店B 里面购买商品满30 减10元。
本片文章比较枯燥,后续按照主体,对象,形式 三个展开讲讲里面的业务抽象,
和相关技术难点。
需求是一个典型的评论盖楼场景,传统的方案是一个自连接的表
自连接表,表新增一列(parent_id)外键,该列引用当前表的id值
自连接表的查询,一般都数据当成一个list全部查出来,在应用服务内构建
成一个树结构,再去做其他处理。如果一个文章的评论特别多,例如微博热帖这种场景,性能就回成为瓶颈。
因此通过自己构建树形索引结构,优化查询性能。
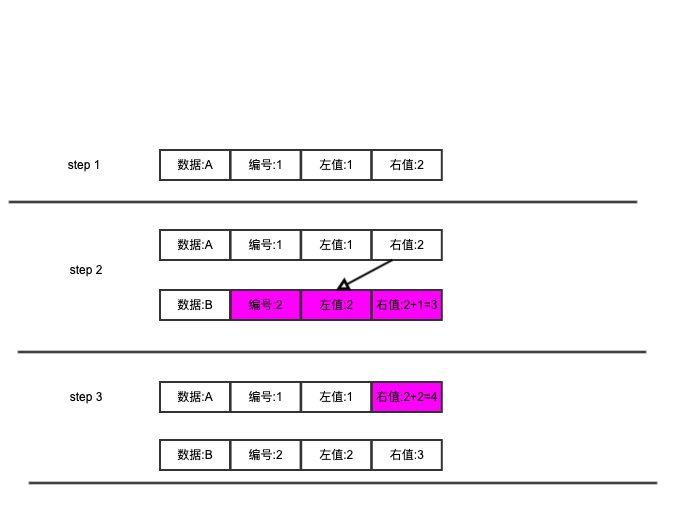
假设db有评论A 。此时A的左值是1,右值是2,编号是1,对应图里面的step1
在A评论下新增B评论,对应图里面的step2
当前树下其他节点左值更新
当前树下其他节点右值更新
其他节点编号更新
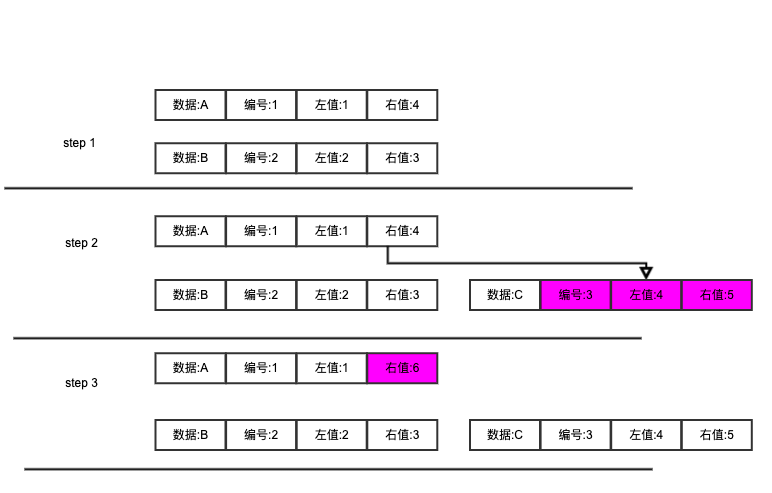
该场景与场景1一样
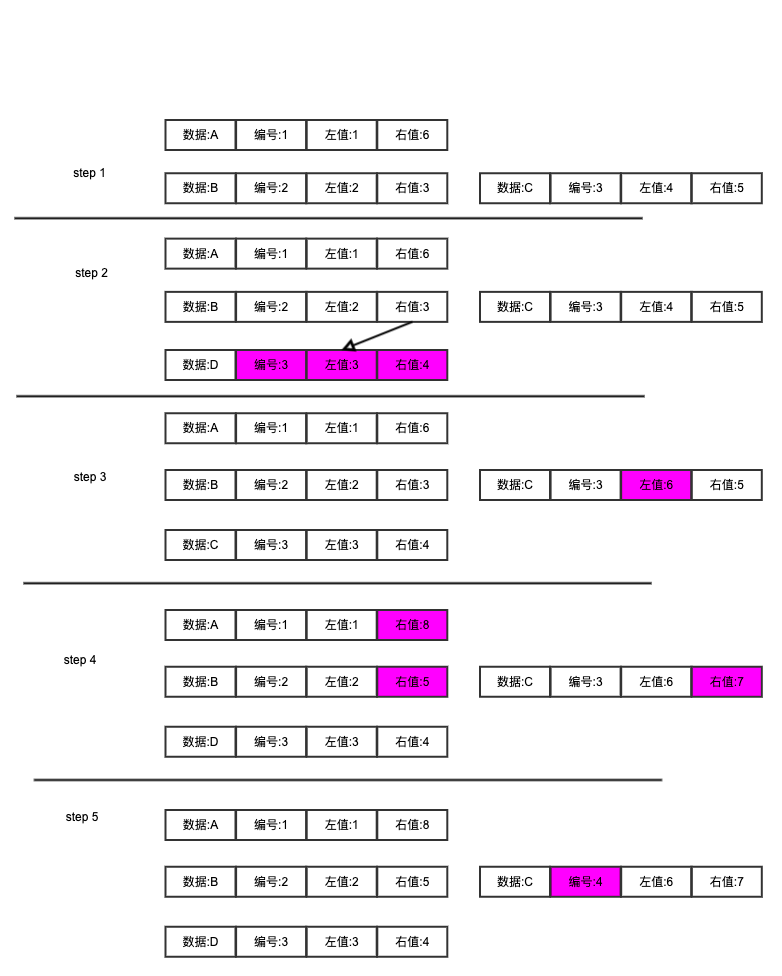
1 |
|
1 |
|
1 |
|
目前maven/gradle已经成为j2ee应用开发的事实标准,以maven项目为例,常规的微服务工程结构如下

maven分多module的目的主要是做代码依赖隔离,和软件打包控制。按上图所示,api依赖service,
service依赖infra,这个是最简单的一个方案,实际项目中还有以下几种变种。
api 基于cqrs原则拆分成读写两套api,不拆maven module,一般通过类或者包拆分
service 可以基于垂直业务领域拆包,或者拆module(不建议,如果需要到拆module的程度,建议拆服务)
基于水平业务拆分一层biz module 出来,解决service本身臃肿和复用问题。
把service拆成可复用的单事物业务,和不可复用的大型业务两种。单事物业务之间不可互相引用。
也可以单独把main函数拆成一个独立module,方便集成测试和单元测试,常见于spring boot项目
infra 把数据库访问单独拆 module,避免研发人员使用其他中间件api
基于代码稳定性考虑,把soa client单独拆一个module,最大限度的隔离下游服务对核心业务代码的影响。

api 与传统项目的api模块没有区别
service 与传统项目的service模块相比,都是无状态的,也是事物的核心过程,但不是业务逻辑的核心实现,
业务逻辑包装在domain内,service主要是协调一个或者多个domain对象,并且不能访问infra
infra 与传统项目的infra模块相比,依赖domain,代表是domain领域对象依赖组件的具体实现
domain 领域驱动架构的核心业务代码层,代码稳定,不依赖其他任何module,无外部依赖(基本只依赖java sdk)
便于单元测试 和代码迁移
application main函数所在模块,主要是方便集成测试,和service模块的单元测试,并且mq的消费者也建议在该模块
软件研发好比行军作战,领域划分则属于战略设计,影响整体大局。
现代软件研发大部分都是迭代研发,整体的领域划分也会随着迭代调整,是一个演变过程,贯穿整个研发周期。
如何做领域划分,有以下几个原则
水平划分是基于业务层级,受应用架构的影响,一般会分 接入层(网关层),服务层,基础层。
水平层级的依赖一般是单向的,即上层依赖下层。
直接提供给外网访问数据,一般对接app或者h5,处理鉴权等。
提供具体业务服务能力,一般不对外,只提供soa接口,业务变更频繁,迭代快
具体业务服务依赖的一些通用服务,例如统一账户服务等,业务相对稳定,迭代慢
垂直划分,是基于一个水平层级能,基于细分业务领域拆分,例如原来商品和商户在一个业务服务,后面随着
业务发展,拆成2个独立的垂直业务服务。垂直划分的服务依赖可以是双向,最终在同一个水平层级内不同的垂直服务的
依赖关系会发展成网状,这个会增大服务治理的难度。
非功能性拆分,一般有to B/to C拆分,实时/离线拆分
常见于cqrs风格架构,b/c两边的性能要求不一致,迭代频率不一致,稳定性保障不一致等导致切分服务
离线/实时场景下,大部分采用的技术栈不一样,语言不一样,虽然多语言应用在微服务里也是可行的,但为了简化研发和维护成本,一般还是拆分。
这个是一个没有标准答案的问题,仁者见仁,智者见智。以上几个原则是做划分时的一个主要参考。划分也不是一锤子买卖,
所有的抽象都是建立在已知用例上,业务会变,会新增用例,当新增用例无法套到现有的领域划分里面,就需要调整领域划分。
领域划分解决了战略设计问题,那么领域建模则是具体的战术设计。领域建模是面向对象分析的方法论,
它可以利用面向对象的特性(封装、多态,继承)有效地化解复杂性。区别于传统的面向数据模型建模(er图),
领域建模是以对象模型为中心,建模过程就是面向对象分析过程,具体的建模过程,建议使用uml来辅助建模,常见的
uml建模图有以下几种
用例图是基于场景的模型,描述了人员使用该软件系统做了什么,是需求功能的直观抽象
类图描述了领域模型核心属性和功能,并体现了面向对象的特性(继承,封装,多态)
流程图描述了业务流程的节点,和相关流转
时序图细化某个用例的具体实现,体现在该场景下不同应用节点之间的交互时序
体现服务应用之间的层级,业务边界,依赖关系,支撑领域划分
ringBuffer顾名思义就是环形缓冲区,常用来做高速缓冲队列,采用环形复用(缓存区写满之后,从首地址重新写入),使用较小的实际物理内存实现了线性缓存。例如著名的Disruptor高性能的主要原因就是使用了ringBuffer。
1 |
|
1 |
|
如果buffer的size是2的n次方,那么取模运算可以替换成位运算.代码参考如下
1 |
|
cpu加载数据是基于缓存行(具体原理不展开了),java8支持通过@sun.misc.Contended来解决这个问题,
非java8版本可以参考Disruptor的做法 https://github.com/LMAX-Exchange/disruptor/blob/master/src/main/java/com/lmax/disruptor/RingBuffer.java
暂时没有想到好方案,目前大致思路是,设置一个阀值算法,满足阀值则重置大小,类似java集合扩容一样,但这个会导致读写锁住。
如果是串行调用,则整体时间是 (500/100)20+(500/30)30.采用ringBuffer解耦两个接口依赖,则优化后的rt时间,
理论上可以缩减至30ms左右(排除cpu切换上下文损耗等)
JSR-133规范,JavaTM内存模型与线程规范.该规范语义不会去描述多线程程序该如何执行。
而是描述多线程程序允许表现出的行为。
JMM来源于JSR-133,主要解决多线程对共享数据的读写一致性问题,
JVM内存模型则是指JVM的内存分区。两者本身没有关系。
能够在线程间共享的内存称作共享内存或堆内存。所有的实例字段,静态字段以及数组元素都存储在堆内存
中。我们使用变量这个词来表示字段和数组元素。方法中的局部变量永远不会在线程间共享且不会被内存模型影响
线程间的动作是由某一线程执行,能被另一线程探测或直接影响的动作(action)。线程间的动作包括共享变量的读写以及同
步动作(synchronization action),如 lock 或 unlock 某个管程,读写某个 volatile 变量或启动一个线程。
也包括与外部世界交互的动作。
线程内语义是单线程程序的标准语义,基于某个线程内读动作能看到的值,可以完整的预测这个线程的行为。线程内语义决定着某个线程孤立的执行过程;当从堆中读取值时,值是
由内存模型决定的。
同步动作包括锁、解锁、读写 volatile 变量,用于启动线程的动作以及用于探测线程是否结束的动作。
jsr133强化了volatile语义,需要有acquire和release语义,对某个volatile字段的写操作happens-before每个后续对该volatile字段的读操作
jvm通过内存屏障来保障volatile语义,硬件层面的内存屏障分两种store Barrier和load Barrier,jvm通过两种组合成四种即loadload,
loadstore,storestore,storeload.
CPU缓存的出现主要是为了解决CPU运算速度与内存读写速度不匹配的矛盾,因为CPU运算速度要比内存读写速度快得多。
导致CPU可能会花费很长时间等待数据到来或把数据写入内存。
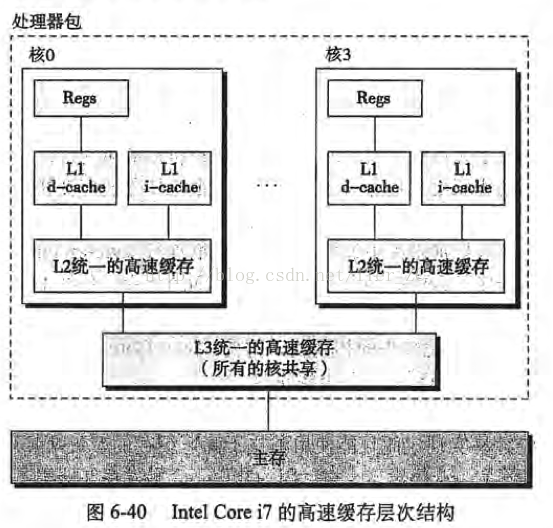
每一级缓存中所存储的数据全部都是下一级缓存中的一部分,这三种缓存的技术难度和制造成本是相对递减的,所以其容量也相对递增。
当CPU要读取一个数据时,首先从一级缓存中查找,如果没有再从二级缓存中查找,如果还是没有再从三级缓存中或内存中查找。
演示java代码
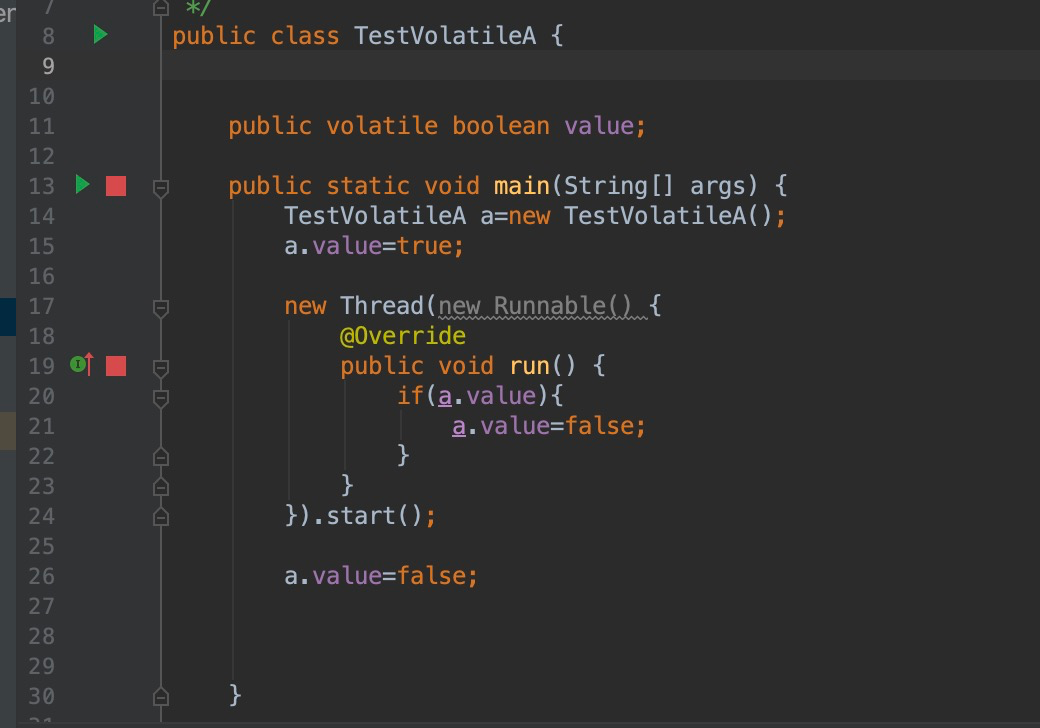
在新增jvm参数之后可以打印对应的汇编指令
1 |
|
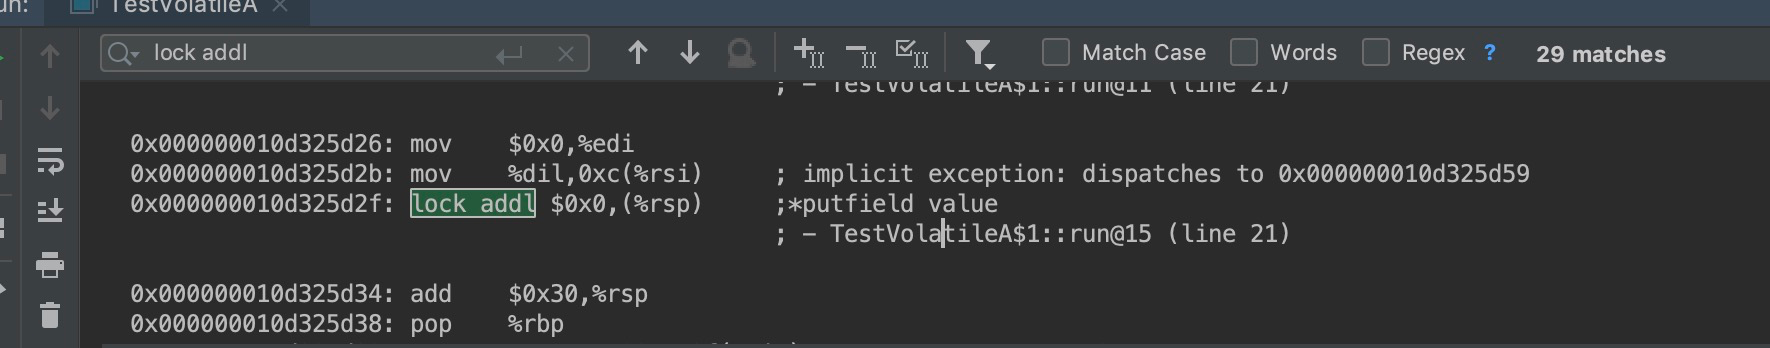
jvm并没有采用Barrier指令而是采用了lock addl $0x0,(%rsp)来实际上保障volatile语义。
lock是一个前缀指令,是和其他指令配合使用 addl $0x0,(%rsp)实际上就是+0,是一个无效指令,配合lock前缀锁定cpu总线(实际上是锁缓存),
lock后的写操作会回写已修改的数据,同时让其它CPU相关缓存行失效,从而重新从主存中加载最新的数据
相关资料
https://software.intel.com/sites/default/files/managed/a4/60/325384-sdm-vol-3abcd.pdf 2.85
缓存是分段(cache line),每次加载的缓存是定长的,通常是64位。lock其实不是锁总线是是锁定缓存段.
cpu缓存一致性协议,把cpu缓存行的数据分成4个状态,用2个bit表示
其中M和E解决独占问题(也就是锁的语义),lock前缀配合一个写操作,整个缓存行的状态会从s->e->m->i->s
cpu每次load数据是基于缓存行加载的,如果两个变量公用一个缓存行(一般是相同低bit位地址),就会产生缓存伪共享的问题,只打算更新a变量的只,结果导致b变量也一起更新。
解决的思路是把a变量独占一行,例如独占64位。Java8中已经提供了官方的解决方案,
Java8中新增了一个注解@sun.misc.Contended。加上这个注解的类会自动补齐缓存行,需要注意的是此注解默认是无效的,需要在jvm启动时设置-XX:-RestrictContended才会生效。